快速了解
它能做什么
面向 DeepSeek Harness 网页端的全双工语音插件,提供本地语音识别、字幕、回复朗读和开口打断。
本站提供的是中文说明,不代表该项目或 Plugin 自身提供中文界面;语言支持请以上游文档为准。
Web Profile
>=0.1.1-rc.2
证据已验证
核对日期 2026/9/16 UTC 13:54
有代码证据的贡献
它为 DSH 增加什么
为 DSH 网页会话加入麦克风输入、流式草稿、回复朗读、实时字幕和打断控制。
机制证据 ↗选择前先看
可在 DSH 会话中使用语音模式:说话时内容会以草稿形式持续显示,停顿后可自动发送;回复会按句朗读并显示实时字幕。朗读过程中开口可打断当前播放。项目描述 ASR 使用本地 zipformer2 与 SenseVoice 推理;TTS 支持 Edge,以及可选的本地 VITS 或 Kokoro。
适合谁
希望通过语音输入并收听回复的 DeepSeek Harness 网页端用户。
常见任务
- 口述提示词,并在发送前查看流式草稿。
- 通过同步字幕收听助手回复。
- 打断较长的语音回复并立即继续对话。
- 调整识别语言、热词、字幕大小和打断行为。
权限与数据
语音输入需要浏览器麦克风权限。项目称语音识别在本地进行,但默认 Edge TTS 路径使用云端服务。
权限- 浏览器麦克风权限。
- 项目描述麦克风音频由宿主端本地 ASR 处理。
- 选择默认 Edge TTS 时,待朗读文本会发送至 Edge 云端 TTS。
- README 将本地 VITS 和 Kokoro 描述为可让回复文本留在设备上的替代方案。
- 选择默认 Edge 引擎时使用 Microsoft Edge TTS。
- 项目声称本地语音识别无需 API Key。
局限
- Ctrl+Shift+V 会覆盖浏览器“粘贴为纯文本”的快捷键。
- Safari 和 iOS 需要 HTTPS 或 localhost 及麦克风授权;后台或锁屏时识别和朗读会暂停。
- 首次加载模型可能需要网络;本地 TTS 引擎可能需要加载模型。
- 提供的证据未实际执行安装、麦克风功能、本地模型运行或 TTS 传输。
DSHub 已核对
- 固定提交中包含已验证结构的 DSH bundle manifest 和 Cordis patch。
- 包元数据声明 Node.js >=18.0.0 与 DSH >=0.1.1-rc.2。
- 包标识为 MIT 许可证。
- README 记录了语音输入、字幕、打断、配置和 DSH 安装命令。
DSHub 未核对
- 提供的证据未执行安装或运行时测试。
- README 中关于端到端版本测试、测试数量、安全加固、模型校验和性能的声明未被独立验证。
- 未审计 npm 注册表包的实际内容。
固定版本安装
安装 dsh-voice-mode
这个Plugin Bundle没有 DSH Plugin 安装操作,请根据源码文档使用真实交付方式。
维护者原文
项目 README
Full-duplex voice mode for DeepSeek Harness —— 在会话内用语音完成整轮对话:说话时边说边出字、停顿后自动发送;回复按句朗读并跟随实时字幕;朗读中开口即打断。识别在本地推理、无需 API Key;朗读默认 Edge 云端(快且自然),本地 VITS / Kokoro 可选(隐私优先)。兼容 dsh 0.1.1-rc.2 起全版本(已在 0.1.1 / 0.1.2 / 0.1.5-rc.1 / 0.1.5-rc.2 端到端验证)。当前版本 v0.7.7,254 项测试全绿。
💡 它是什么
在 DeepSeek Harness 的会话里,点一下麦克风就能用语音完成整轮对话:
- 🎤 你说 —— 一边说一边实时出字(流式识别),停顿约 1500ms 自动发送;
- 🔊 它答 —— 最终回复按句朗读,全程实时字幕跟随;
- ⏸️ 随时打断 —— AI 还在朗读时开口即打断,你的话直接被听见。
零 API Key:识别在宿主端本地推理(zipformer2 流式 + SenseVoice 定稿);朗读默认 Edge 云端(快、自然),可选本地 VITS 纯中文 / Kokoro 中英混读(回复文本不出本机,隐私优先)。
🤔 为什么值得用(5 个真痛点)
| # | 痛点 | 我们的应对 |
|---|---|---|
| 1 | 专有名词识别不对 —— 「dsh-voice-mode」总识别成「DSH voice 模式」 | 识别热词偏置 asrHotwords: "dsh-voice-mode:2.5" —— 显著提升专有名词召回 |
| 2 | 语种乱漂 —— 中英混说时句子中途跳英文 / 一锁 en 又跳回中文 | recognitionLanguage = auto/zh/en/ja/ko/yue 6 语种锁定 + 重建 worker |
| 3 | 字幕看不清 —— 字小、窄屏被输入框挡住 | captionFontSize 4 档(12/14/18/24px)+ captionMaxWidth 3 档(50/70/90vw) |
| 4 | 让位误打断 —— AI 朗读时插一句「嗯/对」就被硬打断 | backchannelYield 让位语义:短词自动让位 1.5s,真要说走才硬打断 |
| 5 | 本地 TTS 太机械 —— 一句话读完停顿 3-5 秒 | 本地 VITS / Kokoro 原生 addon + epoch 队列管理,按句流式朗读、句间无停顿 |
✨ 功能(按用户价值)
- 🎙️ 识别准 —— 热词偏置 + SenseVoice 多语种 + ITN(数字/日期/货币自动规范化)
- 🗣️ 不说错 —— 唤醒词待机、唤醒词前缀语气词白名单(
嗯/那个不再误触) - 🤝 让位 —— 让位语义 + 三档打断灵敏度(
interruptLevel),外放也能精准打断 - 💬 有感情 —— 本地 Kokoro 103 音色 + Edge 322 音色,行内可试听;分段朗读不漏句
- 👁️ 字幕 a11y —— 4 档字号 + 3 档宽度,浅色主题变量跟随 dsh 主题
🎬 Demo
真实录屏见
demos/RECORDING-SCRIPT.md(60s/30s/15s 三段脚本)。
真机截图清单见screenshots/MANIFEST.md(12 张)。
🚀 5 分钟上手(Quick Start)
dsh plugin --profile web add dsh-voice-mode
systemctl restart dsh   # Linux;其他平台重启 dsh 进程
第一次用:
- 进入任一会话,按
Ctrl+Shift+V(或点输入区麦克风按钮)进入语音模式,状态条显示「聆听中…」; - 说一句完整的话(如「帮我看看今天的天气」)→ 实时字幕立即出现,停顿后自动发送;
- AI 回复开始朗读时,开口说话 → 朗读即刻停止,你的话被听见(这就是 barge-in)。
操作手势
| 手势 | 作用 |
|---|---|
Ctrl+Shift+V |
进入 / 退出语音模式 |
| 直接说话(toggle) | 边说边出字,停顿 1500ms 自动发送;按住 Ctrl 强制立即发送 |
| 按住麦克风按钮(hold) | 松手发送;短按退出;滑出 / Esc / 失焦放弃本段 |
| 点输入框旁模式按钮 | 在「持续聆听 ⇄ 按住说」间切换(保存到设置) |
| AI 朗读时开口说话 | 打断朗读并取消当前回合 |
| 点状态条「退出」 | 退出语音模式 |
| 点字幕浮层「跳过」 | 跳过当前句朗读 |
⚙️ 配置(7 新设置字段 + 5 默认值微调)
设置 → Plugins → 插件配置 → 语音模式(voice-mode)。
7 新设置字段(11 批次周全修复落地)
| 你想调什么 | 改哪个键 | 默认 | 说明 |
|---|---|---|---|
| 识别热词 | asrHotwords / asrHotwordsScore |
空 / 1.5 |
每行一词或「词:分数」(如 dsh-voice-mode:2.5);变更触发 recognizer 重建 |
| 识别语种 | recognitionLanguage |
auto |
SenseVoice 多语:auto / zh / en / ja / ko / yue;切换终止并重建 worker |
| 逆文本归一化 | senseITN |
true |
SenseVoice 数字/日期/货币规范化(默认开,关掉保留原文) |
| 字幕字号 | captionFontSize |
0 |
档位 0=12px / 1=14px / 2=18px / 3=24px |
| 字幕宽度 | captionMaxWidth |
1 |
档位 0=50vw / 1=70vw / 2=90vw |
| 让位语义 | backchannelYield |
true |
朗读期说「嗯/对」自动让位 1.5s,真要说走硬打断(ADR-0008) |
5 默认值微调(批 J)
| 字段 | 旧 | 新 | 理由 |
|---|---|---|---|
rate |
1.0 | 1.1 | Edge 默认略慢,统一提速 10% 改善体验 |
idleTimeoutMinutes |
10 | 5 | 空闲退出更灵敏(朗读仍计为活动) |
interruptLevel description |
旧描述 | 新描述 | 明确「3/2/1 帧确认」机制 |
字段名零变化,旧
~/.dsh/settings.yaml100% 兼容。
完整 19 项设置表见 plugin/dsh-voice-mode/README.md。
🏛️ 架构(Architecture)
flowchart LR
    subgraph Client["浏览器 Client"]
        Mic[麦克风 16kHz<br/>AudioWorklet] --> VAD[客户端 VAD<br/>RMS 分段]
        VAD -->|partial 0.9s| PC[partial 出字 + 字幕浮层]
    end

    subgraph Host["宿主 dsh.host"]
        ASR[zipformer2 流式识别<br/>host 端 WASM] --> SV[SenseVoice 定稿<br/>+ ITN + 标点]
        SV --> Draft[composer draft<br/>autoSend]
        Draft --> Tap[llm/stream tap<br/>仅观察·不阻塞]
        Tap --> Seg[sentence segmenter]
        Seg --> Q[TtsQueue<br/>epoch 打断]
        Q --> TTS{引擎}
        TTS -->|edge| Edge[Edge 云端]
        TTS -->|vits| Vits[本地 VITS<br/>WASM]
        TTS -->|kokoro| Kokoro[本地 Kokoro<br/>原生 addon]
    end

    PC -->|audio f32 PCM| ASR
    Edge -.->|SSE audio frame| PC
    Vits -.->|SSE audio frame| PC
    Kokoro -.->|SSE audio frame| PC
    VAD -.->|唤醒词/打断| Host
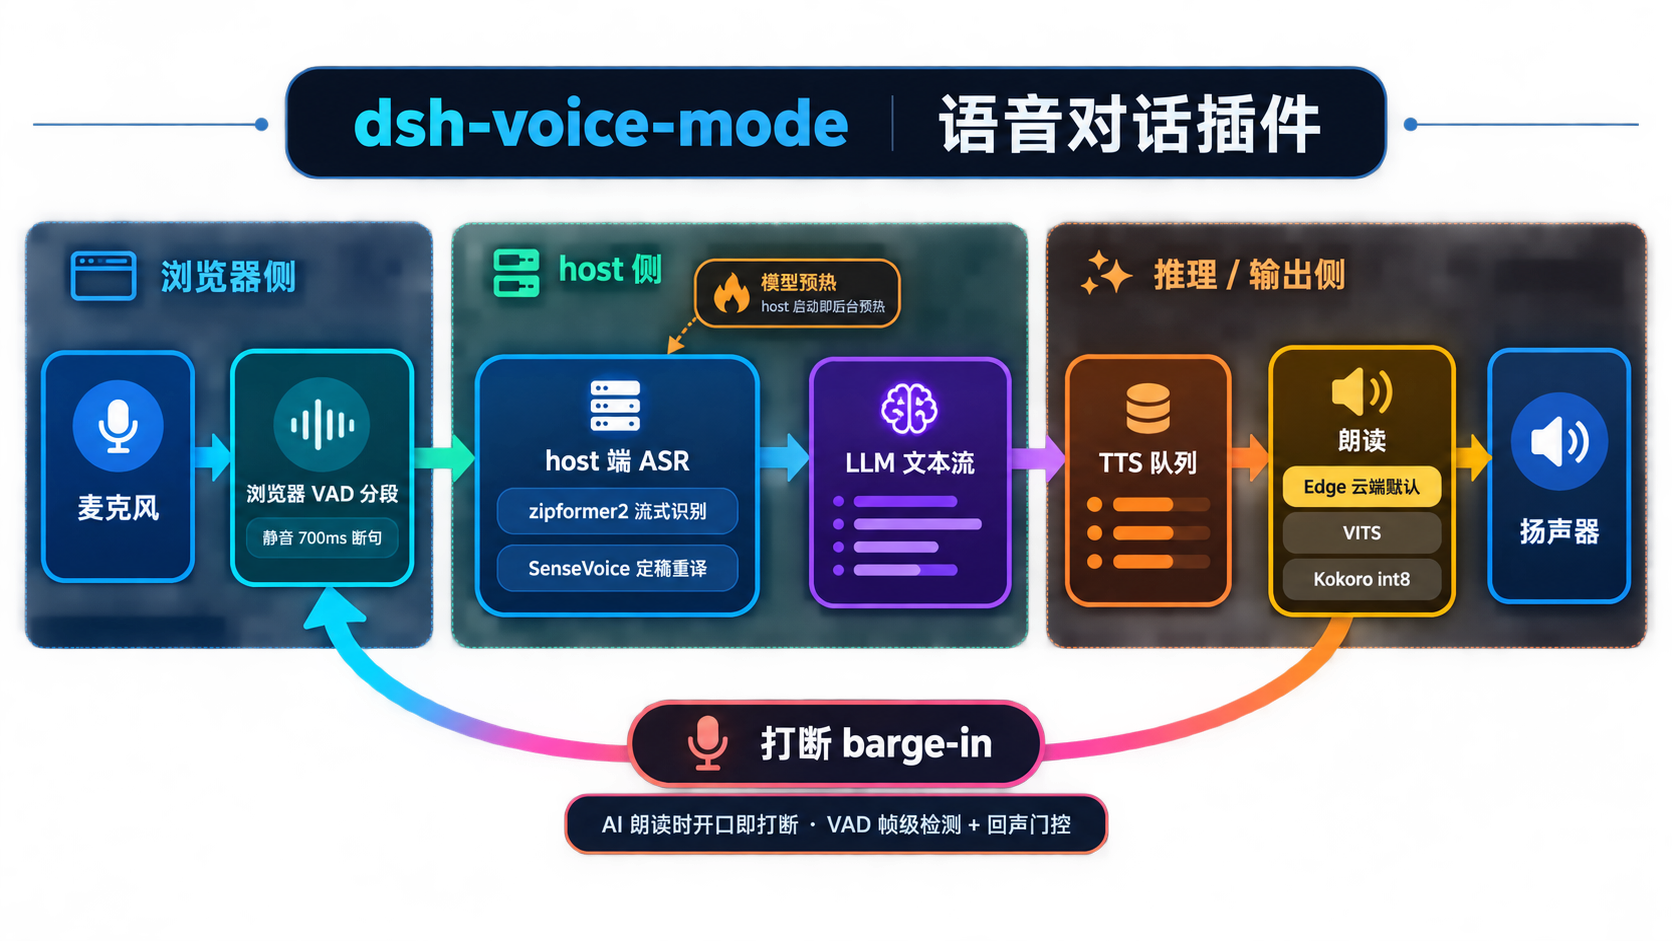
详细架构决策:见 docs/adr/ 8 个 ADR。
🔍 与 dsh 内置语音模式对比
| 维度 | dsh 内置 | dsh-voice-mode(本插件) |
|---|---|---|
| 识别模型 | 云端 API(需 key) | 本地 zipformer2 + SenseVoice(零 key) |
| 多语种 | 英文为主 | 6 语种 auto/zh/en/ja/ko/yue + ITN |
| 朗读引擎 | 云端 TTS | Edge 云端 + 本地 VITS/Kokoro 三选一 |
| 打断检测 | 基础 VAD | 三档灵敏度 + 回声门控 + 让位语义 |
| 热词偏置 | 无 | sherpa-onnx 热词 + 偏置分 |
| 字幕 a11y | 无 | 4 档字号 + 3 档宽度 + 主题跟随 |
| 唤醒词 | 无 | 轻量流式匹配 + 前缀语气词白名单 |
| 兼容 dsh | — | 0.1.1-rc.2 → 0.1.5-rc.2 全版本 |
🛠️ 故障排查
| 现象 | 处理 |
|---|---|
| 点麦克风无反应,状态条红字 | 浏览器拒绝麦克风:地址栏(iOS 为 设置 → Safari → 麦克风)开启后重试 |
| 状态条「正在加载模型… x%」卡住 | 检查网络;模型较大可先 npm run prefetch;国内网络 modelHost 配 https://hf-mirror.com |
| 朗读无声音 / 无字幕 | 本地引擎首次合成需加载模型;若持续失败看状态条提示(自动退避重试);确认页面前台且未静音 |
| 语音模式进不去 | 检查插件 enabled;多标签页时确认当前会话为活动会话 |
| 识别到但不是我要说的 | 环境噪声:降低音量或提高 interruptLevel(高门槛) |
| 打不断(朗读中开口无反应) | 调高 interruptLevel(更敏感档)或检查麦克风权限;不要调 echoGateDb——原生 AEC 生效时它从未被执行(详见 ADR-0006) |
| 热词不生效 | 检查 asrHotwords 是否为空(空 = 关闭);热词变更触发 recognizer 重建,下次进入语音模式生效;热词评分过低(<1.0)几乎无效,建议 ≥1.5 |
| 字幕被输入框挡住 | 默认 captionMaxWidth=1(70vw)+ captionFontSize=0(12px)在窄屏可能与底部输入框重叠;调整档位,或关闭语音模式后点状态条浮层右上角「×」收起 |
| 让位行为异常(朗读期说「嗯」不停 / 真话被打断) | 「嗯/对」类短词触发让位 1.5s(hold)后继续朗读;继续说真话会走硬打断;如不要让位语义把 backchannelYield 关闭即可恢复改造前行为(ADR-0008) |
| 朗读期说「嗯」没让位 | 确认 backchannelYield=true(默认开);hold 模式松手后让位 1.5s 内继续说话会变硬打断 |
| 空闲 5 分钟自动退出(不想退) | 调高 idleTimeoutMinutes(默认 5 分钟,朗读计为活动) |
已知限制:
Ctrl+Shift+V会覆盖浏览器「粘贴纯文本」快捷键(普通粘贴仍用Ctrl+V);识别为简体中文优先;Safari / iOS 需 HTTPS 或 localhost、首次需授权麦克风、后台 / 锁屏会暂停识别与朗读。
🛣️ 路线图(Roadmap)
完整 backlog(43 项 P0-P3)见 docs/competitive/backlog.md。
- ✅ 已完成(v0.7.7):11 批次周全修复(识别热词 / 锁语种 / 字幕档位 / 让位语义 / 模型预热 / 默认值微调 / 死代码清理等)
- 🚧 P0(近期):ADR-0003 VAD 下沉 / ADR-0006 第一级探测接通 manual / F1 emotion DSL 全量上线
- 📋 P1(中期):MCP
voice_*工具集 / 卡片表单 draft validate / 状态条 idle 优化 - 💡 P2(远期):声音克隆(用户已决定推迟)/ ADR-0004 WebSocket transport
- ⏸️ 已推迟:xAI fallback / C1 人格层(用户已决定推迟)
📚 文档
| 文档 | 说明 |
|---|---|
| 完整使用说明(中文) | 功能 / 手势 / 设置 / 配置 / 已知限制 / 故障排查 |
| English docs | Same, in English |
| docs/ 索引 | 架构决策 / 实施计划 / 真机验收 / 规则 / 调研 / 竞品 |
| 60 天迭代博客 | 从 91 到 254 项测试的故事 |
| CHANGELOG.md | Keep a Changelog 格式 |
| RELEASE-NOTES.md | 60 天时间线 |
🤝 Contributing / 📄 License / 🙏 Acknowledgments
License: MIT
Contributing: PR 欢迎,但请先读 docs/adr/ 8 个 ADR + CONTEXT.md + docs/rules/STATE.md;仓库遵循 CLAUDE.md 的维护纪律(CLAUDE.md / AGENTS.md 仅存本机,不入库)。
Acknowledgments:
- 上游:haoku123/dsh-voice(派生声明见子包 LICENSE)
- 核心依赖:sherpa-onnx(Apache-2.0,本地 ASR / VITS / Kokoro 推理)/ msedge-tts(Edge 云端 TTS)
- 测试支持:awesome-dsh-plugin(收录到精选列表)
- 11 批次周全修复参与贡献者:见
docs/rules/STATE.md§ 批次进度表
📌 项目维护:仓库遵循「外科手术式改动」纪律 —— 不顺手优化、不重构无关代码、不强推发布历史;每个 commit 单一职责,便于审查与回滚。详见
CONTEXT.md。
有意识地管理
安装与管理
前置条件与目标 Profile
目标: Web Profile
交付方式: Git Bundle — qishuilalala/dsh-voice-mode#a9445521cd9a101be57e59467a340fba6c6be7ae。
验证、更新与移除
显示生命周期命令
dsh plugin --profile web list兼容性与访问范围
Requires Node.js 18+ and DSH 0.1.1-rc.2+: >=0.1.1-rc.2。
风险事实
证据与编辑审查Manifest、Bundle patch、分发与新鲜度
不可变证据
审查状态与源码活动
固定 Git bundle 是最明确的安装来源。启用前请确认麦克风权限,并审查所选 TTS 引擎的数据传输路径。
AI 审查于 2026/9/16 UTC 13:55。GitHub 事实核对日期: 2026/9/16 UTC 13:55。
自当前证据基线以来,没有记录到重要源码变化。